La extracción de datos estructurados de documentos como facturas, recibos y formularios se presenta como un desafío significativo para numerosas empresas debido a la diversidad en formatos, diseños y lenguajes. Los métodos tradicionales, como el reconocimiento óptico de caracteres (OCR) y los sistemas basados en reglas, a menudo no logran abordar estas complejidades, resultando en procesos manuales que son lentos y propensos a errores. Un ejemplo claro es el de un banco regional que debe procesar miles de documentos, lo cual genera cuellos de botella y aumenta el riesgo de equivocaciones.
El procesamiento inteligente de documentos (IDP) emerge como una solución a estos problemas mediante el uso de inteligencia artificial (IA). Esta tecnología clasifica documentos, extrae información relevante y valida los datos obtenidos, facilitando su uso dentro de procesos empresariales. Su meta principal es transformar documentos no estructurados o semi-estructurados en formatos utilizables, como JSON, que contienen campos y tablas de información específica.
En este contexto, los modelos de lenguaje visual (VLM) representan un avance significativo. Estos integran grandes modelos de lenguaje con codificadores de imágenes especializados, lo que brinda capacidades de IA multimodal capaces de realizar tanto razonamientos textuales como interpretaciones visuales. A diferencia de las herramientas tradicionales, los VLM abordan los documentos de manera integral, permitiendo así una extracción de significado con una comprensión contextual sin precedentes.
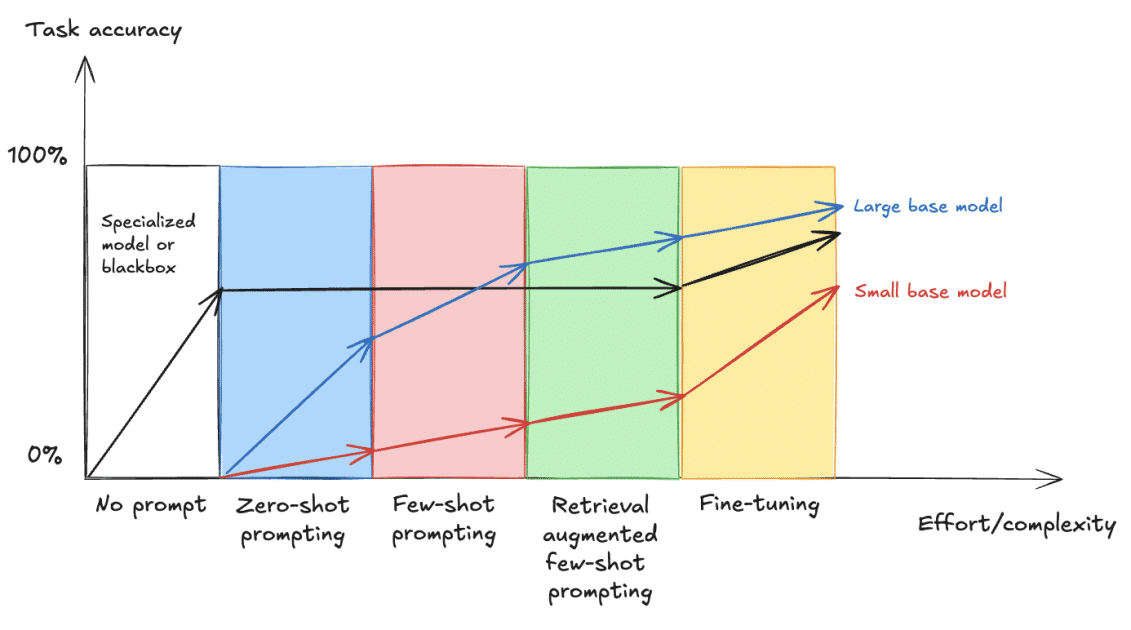
Implementar estas tecnologías puede parecer complicado, pero se presentan diferentes enfoques, incluyendo métodos de ajuste fino que son una solución escalable recomendada. Este proceso utiliza un marco conocido como Swift, que facilita el ajuste de modelos de lenguaje visual para convertir documentos a formatos JSON.
La preparación de datos es igualmente crucial. Se recomienda emplear conjuntos de datos bien estructurados con ejemplos anotados para el ajuste fino de modelos, lo cual permite a los modelos aprender patrones específicos del tipo de documentos que se procesarán. Una vez ajustado el modelo, evaluar su rendimiento es esencial. Medidas como la tasa de error de caracteres y el índice de coincidencia exacta permiten entender la calidad de los datos extraídos y asegurar que se cumplan los estándares empresariales.
Las posibilidades de optimización son vastas, abriendo puertas a soluciones automatizadas que pueden mejorar considerablemente la eficiencia operativa de las organizaciones.