
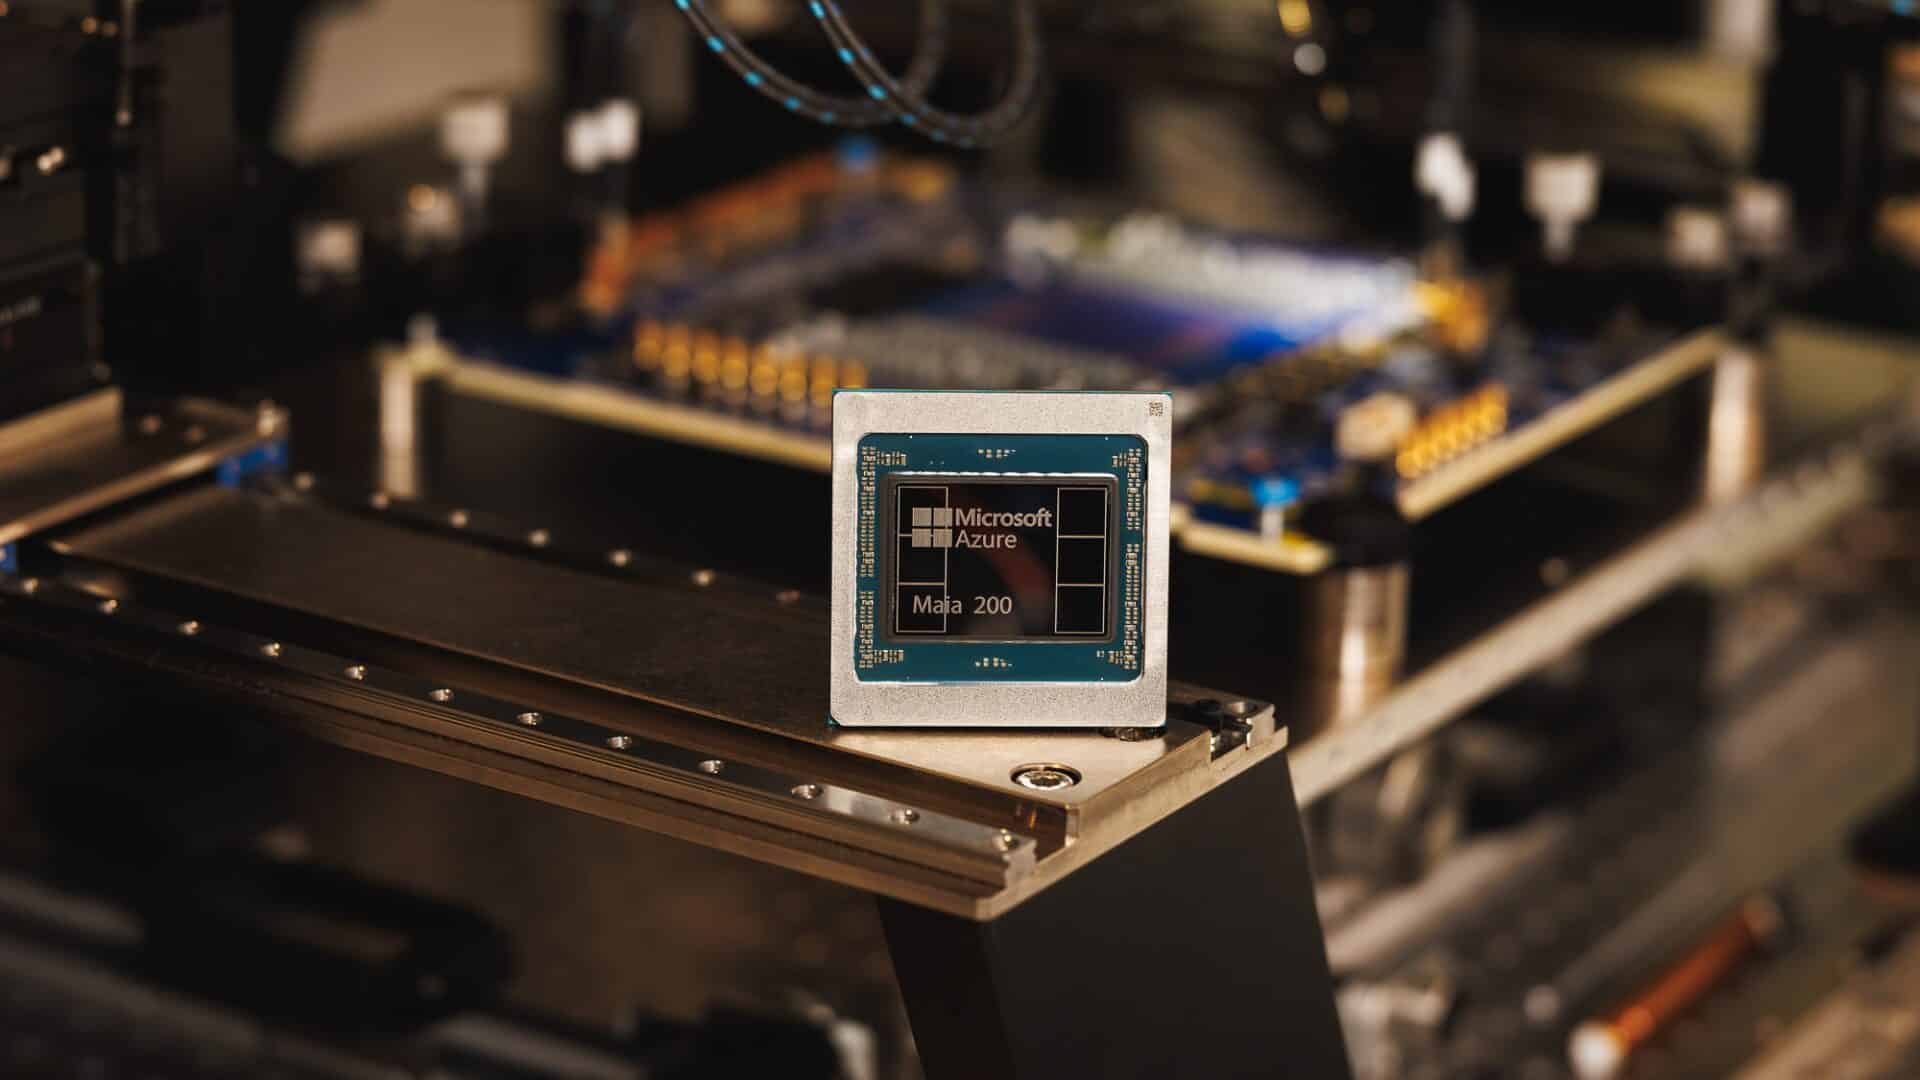
Microsoft ha presentado su último avance tecnológico en la carrera de la inteligencia artificial: Maia 200, un acelerador de inferencia diseñado para mejorar la eficiencia y reducir costos operativos al ejecutar modelos de IA a gran escala. Este desarrollo enfatiza la intención de Microsoft de no solo depender de la potencia bruta de procesamiento, sino también de optimizar el rendimiento por euro invertido, la capacidad de memoria y la eficiencia energética.
En un contexto donde la industria está transformando sus métricas de liderazgo, priorizando el equilibrio entre rendimiento y coste, Microsoft busca posicionarse a la vanguardia. Maia 200 se convierte en una pieza clave de su infraestructura, respaldando múltiples modelos de IA tanto en Microsoft Foundry como en Microsoft 365 Copilot. La nueva tecnología se destaca por su proceso de fabricación en 3 nm y está optimizada para precisiones bajas —FP8 y FP4—, las cuales son habituales en los procesos modernos de inferencia.
Estos avances tecnológicos permiten que Maia 200 maximice la velocidad de procesamiento de tokens, gracias a su cómputo de baja precisión, y a un subsistema de memoria rediseñado que facilita el manejo de modelos grandes. Además, se apoya en redes Ethernet para escalar clústeres densos, lo que evita la dependencia de estructuras propietarias.
Inicialmente, Maia 200 se desplegará en las regiones de US Central y US West 3, con planes de expansión a nivel global. Esta estrategia resalta el compromiso de Microsoft de mejorar no solo el rendimiento de sus aceleradores, sino también la integración de estos en su infraestructura tecnológica.
Con cifras impresionantes, como más de 140,000 millones de transistores y un ancho de banda de 7 TB/s, Maia 200 promete un rendimiento pico significativo, logrando más de 10 petaFLOPS en FP4 y más de 5 petaFLOPS en FP8. Además, según la compañía, representa una mejora del 30% en rendimiento por dólar en comparación con el hardware más reciente utilizado por Microsoft, subrayando su potencial para revolucionar la eficiencia económica del procesamiento en IA.
Maia 200 no solo subraya la importancia de los FLOPS, sino también la correcta alimentación de datos y redes, elementos cruciales para mantener un rendimiento óptimo en inferencia. Microsoft pone especial atención en el SDK de Maia, que ofrece integración con PyTorch y utiliza el compilador Triton, herramientas de vital importancia para simular y optimizar la eficiencia antes del despliegue.
A medida que la infraestructura continúa desarrollándose, Microsoft aclara que Maia 200 está diseñado principalmente para la inferencia, es decir, para servir y procesar modelos de IA de forma eficiente. Con la inclusión de 216 GB de memoria HBM3e, se logra una carga mucho más eficiente de modelos grandes, reduciendo significativamente los cuellos de botella de ancho de banda.
Este lanzamiento representa un paso importante en la carrera por la supremacía tecnológica en inteligencia artificial, destacando el compromiso de Microsoft de proporcionar herramientas más eficientes y rentables para el procesamiento de modelos complejos.
Más información y referencias en Noticias Cloud.