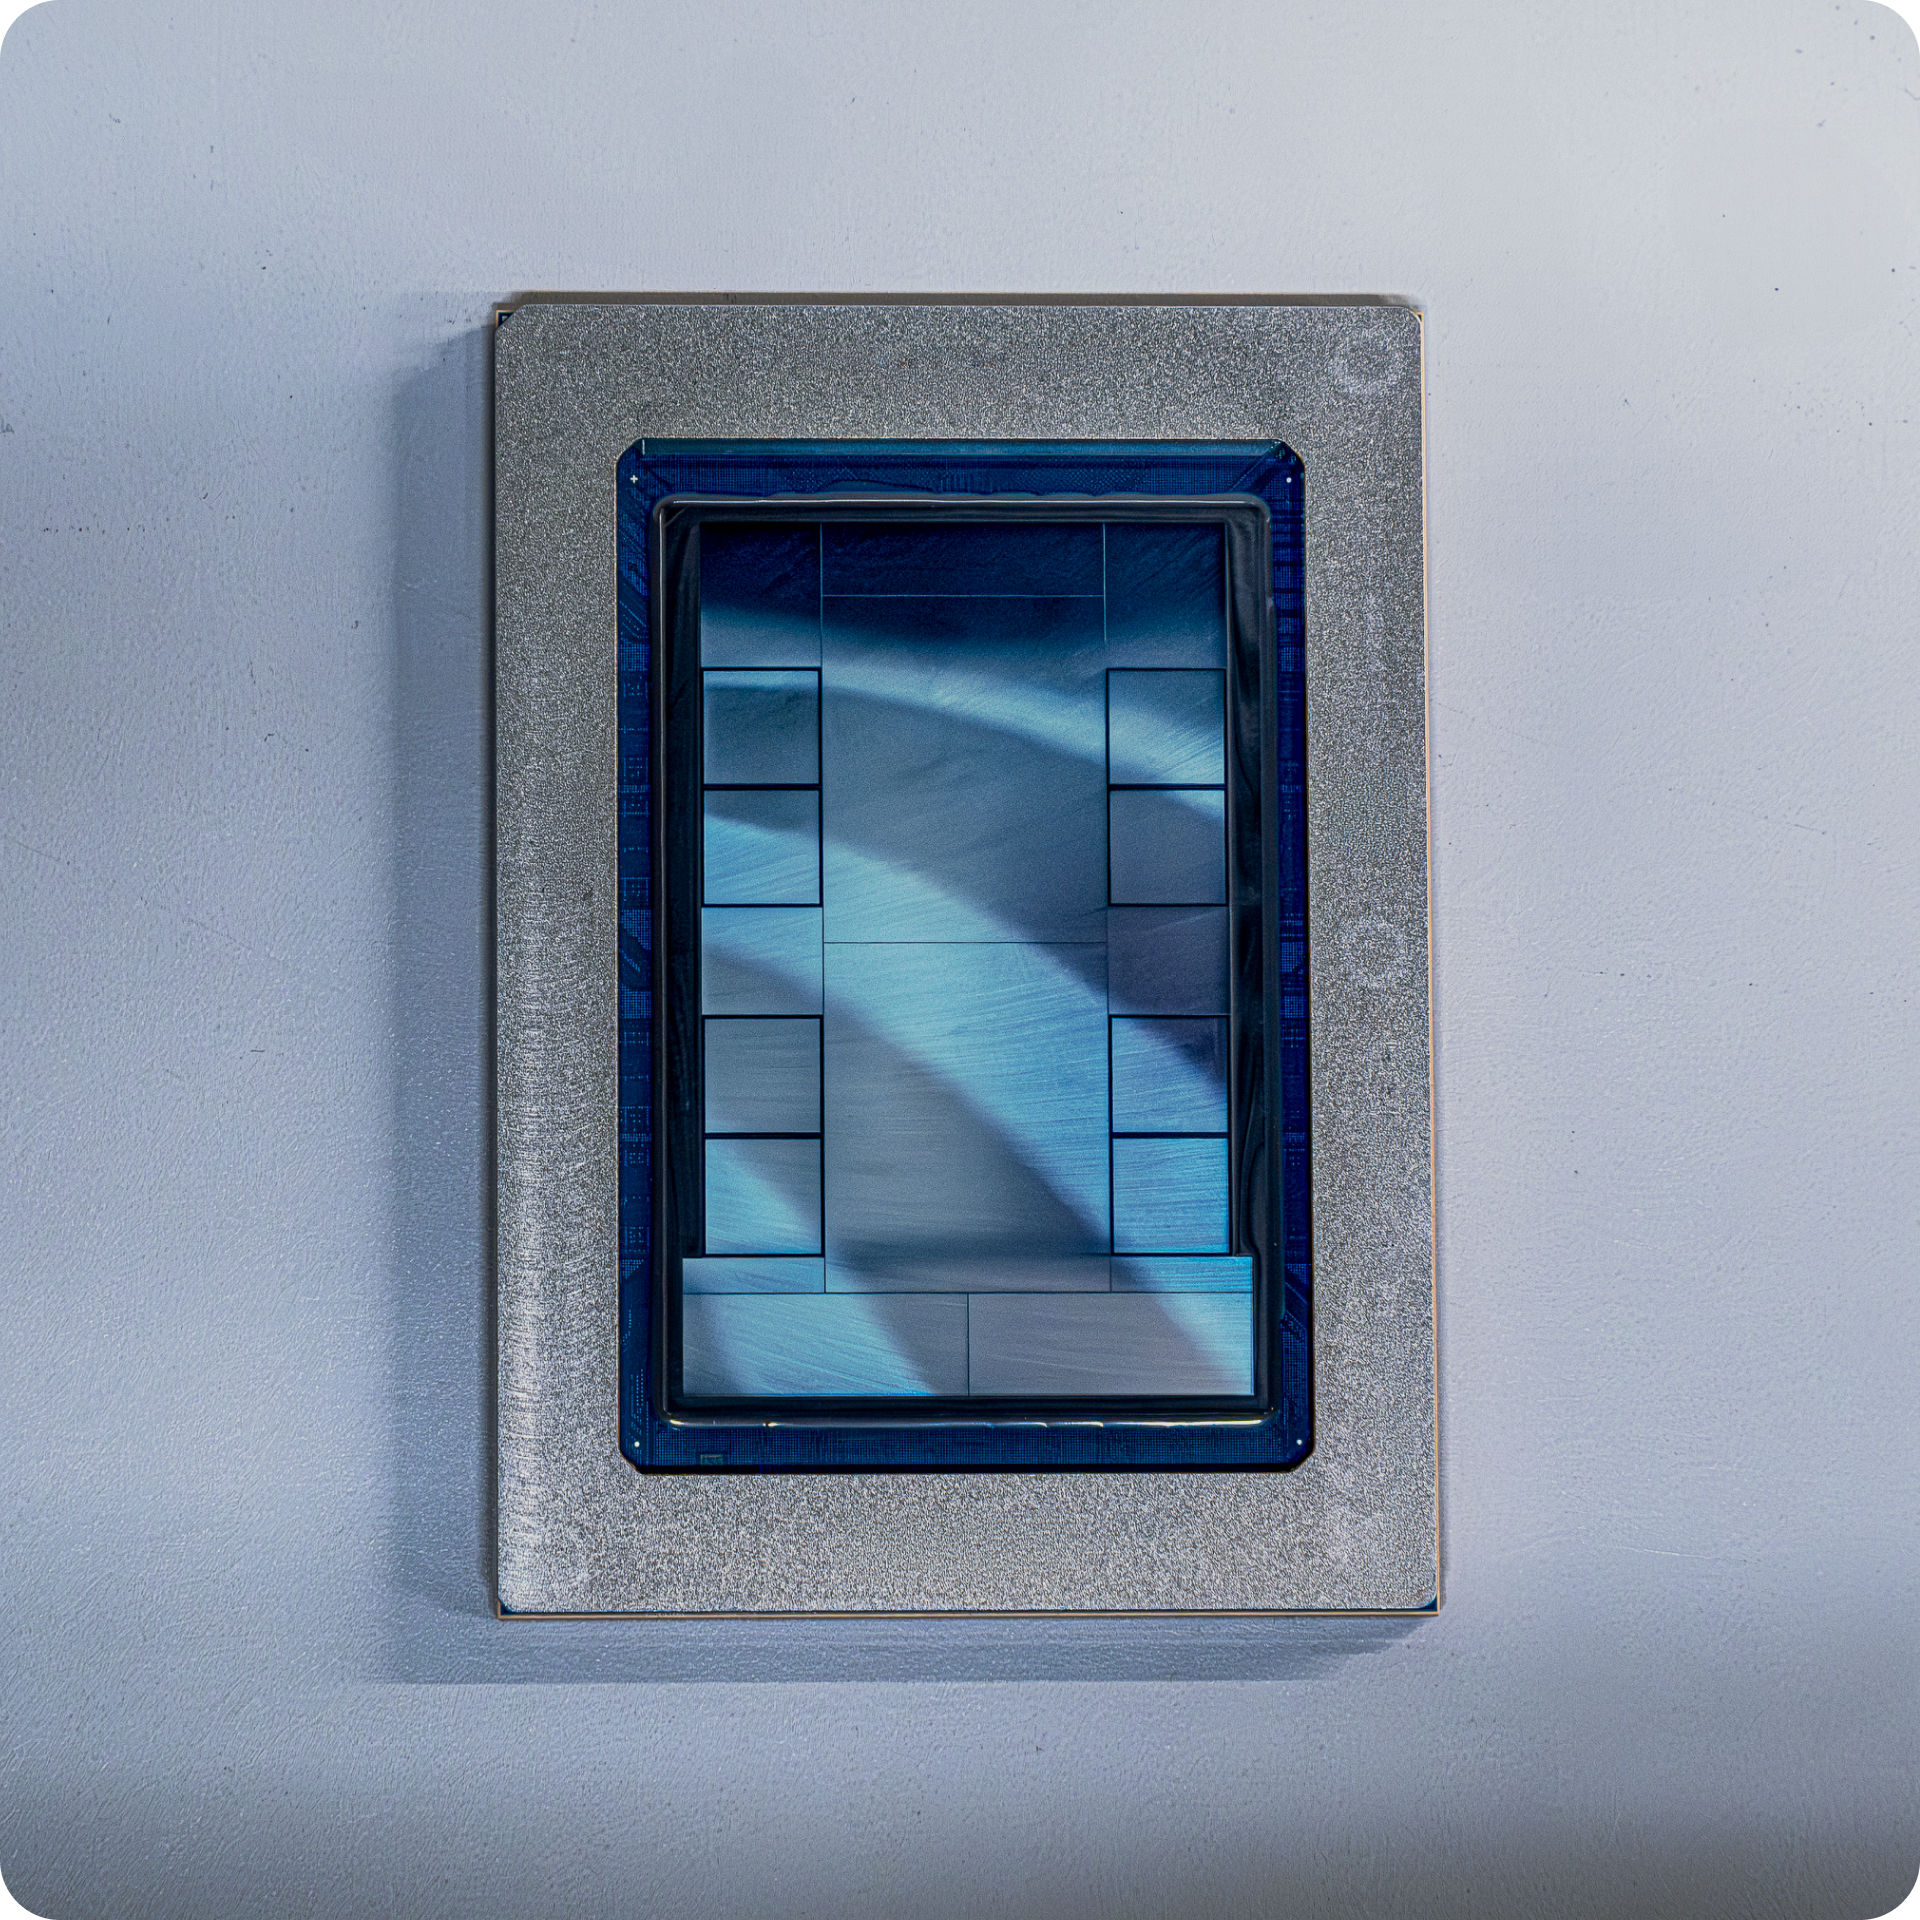
Meta ha decidido acelerar el desarrollo de su familia de aceleradores propios MTIA, marcando un hito en la búsqueda de independencia arquitectónica en el terreno de la inferencia de inteligencia artificial. Con un movimiento estratégico, la compañía ha anunciado el despliegue futuro de cuatro nuevas generaciones de su línea Meta Training and Inference Accelerator, denominadas MTIA 300, 400, 450 y 500, que se espera implementen entre 2026 y 2027. Este paso reafirma una tendencia evidente entre los gigantes tecnológicos: la diversificación más allá de la dependencia exclusiva en GPU, optimizando chips específicamente para tareas de inferencia de IA.
El anuncio de Meta resuena con un ecosistema donde actores como Google, AWS y Microsoft trazan caminos similares. Google ha revelado su TPU Ironwood enfocada en la nueva «era de la inferencia», mientras AWS impulsa Trainium y Inferentia, y Microsoft apuesta por su acelerador Maia 200. Aunque aún no se vislumbra un reemplazo total de Nvidia, sí se está configurando una estrategia de diversificación en la infraestructura de silicio, considerando tanto el costo por token como la eficiencia energética.
El FMIA de Meta, desarrollado en colaboración con Broadcom, ha comenzado su implementación a gran escala, con cientos de miles de chips ya operativos. Esta estrategia avanza sobre una base sólida, habilitando un plan de iteración más agresivo en comparación con los ciclos tradicionales de la industria. Desde el MTIA 300 hasta el 500, se proyecta un aumento significativo en el ancho de banda de HBM y en la capacidad de cálculo, marcando un avance notable en un lapso menor a dos años.
La inferencia se está posicionando como el nuevo campo de batalla tecnológico, desplazando parcialmente el foco del entrenamiento. El cuello de botella en la inferencia generativa ha situado al ancho de banda de la memoria HBM como un factor crucial, algo que Meta ha enfatizado en el desarrollo de sus productos MTIA 450 y 500. Estos avances reflejan un cambio estratégico en la utilización de hardware específico para optimizar costos operativos y rendimiento.
Aunque Nvidia mantiene su rol central, sobre todo en el entrenamiento de modelos avanzados y usos generalistas, la industria vislumbra un cambio en el equilibrio interna de los hiperescalares. Meta y sus pares parecen converger en una lógica común: utilizar GPUs de alto rendimiento para el entrenamiento, mientras que la inferencia masiva se ejecuta en chips propios que prometen mayor eficiencia y economía.
Un punto destacado en la estrategia de Meta es la agilidad en el desarrollo. La empresa tiene en marcha un plan para introducir nuevos chips al mercado cada seis meses, apoyándose en una arquitectura de chiplets modular y reutilizando infraestructura existente, lo que permite una evolución más rápida y sin necesidad de rediseños masivos.
En el trasfondo de esta carrera tecnológica, Broadcom emerge como un socio clave. La colaboración con gigantes como Meta y OpenAI refleja la importancia crítica del diseño personalizado de silicio, una inversión que solo las empresas con vastos recursos pueden acometer. Este panorama sugiere que mientras Nvidia no pierde su trono, el diseño de chips propios enfocado en aplicaciones específicas de inferencia se está consolidando como una opción vital para el futuro de la IA, poniendo en juego la economía de sistemas con una previsión que podría revolucionar el sector.
Más información y referencias en Noticias Cloud.