
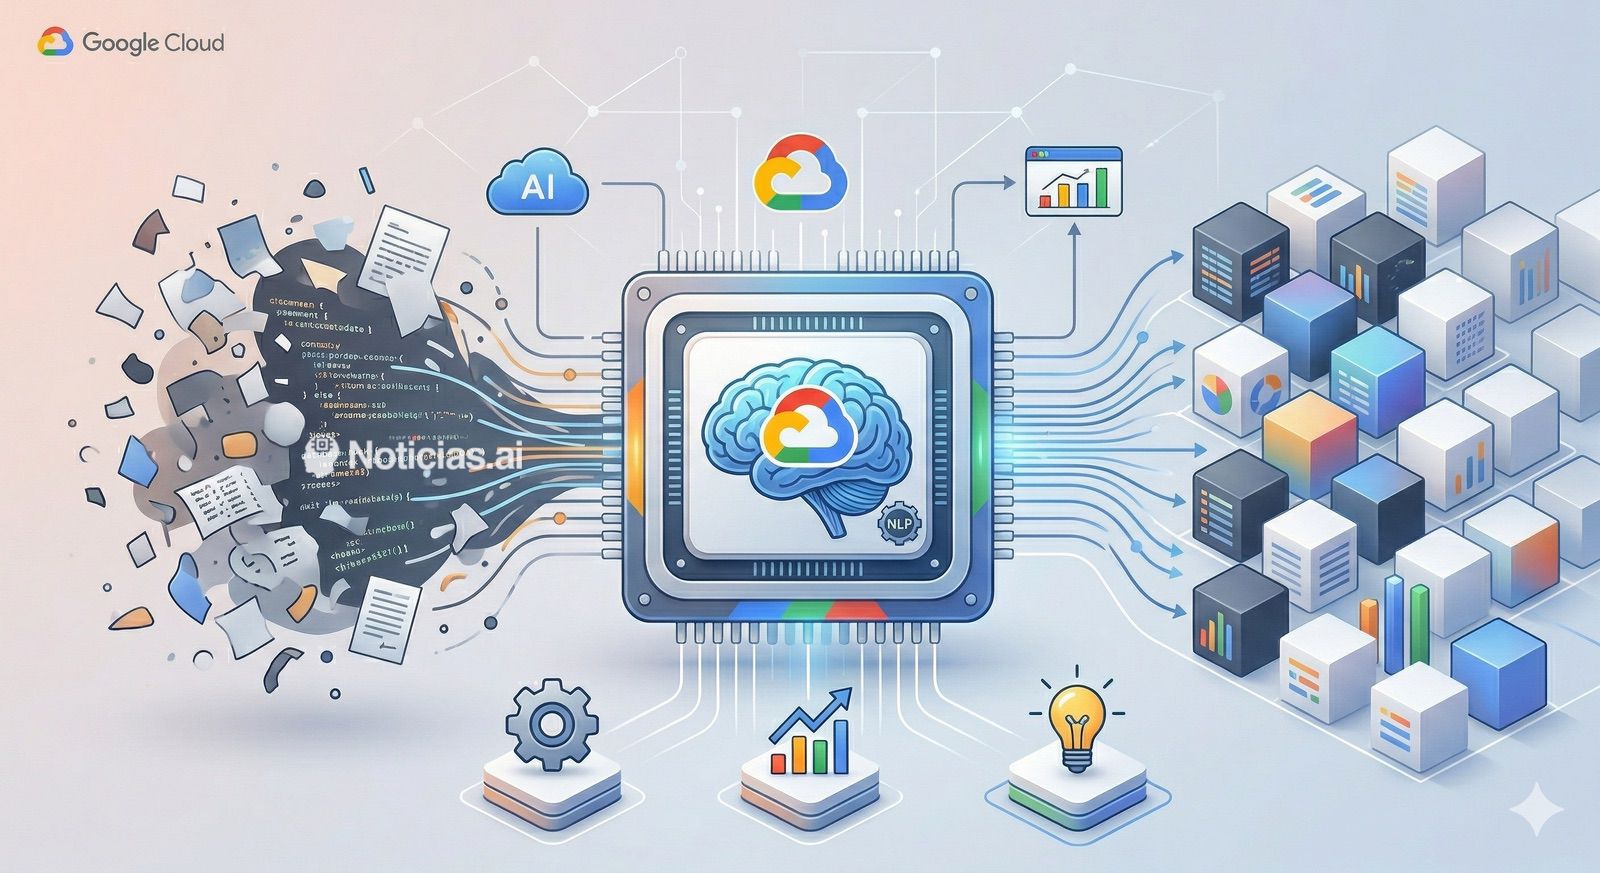
Google ha introducido una herramienta que promete revolucionar la automatización de procesos documentales. Se trata de LangExtract, una librería open source de Python diseñada para transformar texto desordenado en datos estructurados, verificables y trazables hasta el origen exacto del documento. Lanzada oficialmente en julio de 2025, LangExtract se presenta como una solución avanzada para extraer información de documentos no estructurados mediante modelos de lenguaje configurables por el usuario.
En un contexto donde muchas empresas dependen de métodos tradicionales y a menudo ineficaces como expresiones regulares o APIs costosas para extraer datos de contratos o informes, LangExtract eleva las expectativas. Aporta estructura, trazabilidad, revisión visual y flexibilidad en la elección del modelo subyacente, redefiniendo lo que se espera de las modernas herramientas de extracción documental.
Lo que realmente distingue a LangExtract es su capacidad de «precise source grounding», que permite mapear cada dato extraído a su localización exacta en el texto fuente. Esto se traduce en la posibilidad de resaltar visualmente el fragmento original, proporcionando una capa de verificabilidad crucial en sectores donde un error puede tener serias repercusiones operativas o regulatorias.
Además, LangExtract ofrece una visualización interactiva mediante un HTML autocontenido. A simple vista, esta funcionalidad puede parecer trivial, pero transforma significativamente la experiencia de validación. Permite al usuario navegar por las entidades detectadas, verificar su origen y depurar el sistema de manera eficaz. Para flujos de trabajo donde la inteligencia artificial debe interactuar con la supervisión humana, esto representa una ventaja clave.
Diseñado para manejar documentos largos, LangExtract no es solo una solución para textos cortos. Está optimizado para fragmentación de texto, procesamiento paralelo y múltiples pasadas de extracción, capaces de mejorar la recuperación de datos en documentos extensos. Además, su independencia de un único proveedor es un punto a destacar. Aunque impulsado por Gemini, también soporta modelos locales mediante Ollama, OpenAI con dependencias opcionales y admite proveedores personalizados. Esta flexibilidad es especialmente valiosa para organizaciones que valoran la privacidad y optan por despliegues locales en lugar de soluciones cloud.
No obstante, es importante abordar la llegada de LangExtract con una perspectiva equilibrada. No supone el fin de la industria de la extracción documental. El resultado depende de diversos factores, como la calidad del modelo elegido, las instrucciones proporcionadas y la complejidad de la tarea. Aún existen escenarios donde las reglas deterministas y modelos especializados seguirán siendo relevantes.
El repositorio de LangExtract aclara que no es un producto oficialmente soportado por Google, sino una aportación de código abierto para la comunidad desarrolladora. Sin embargo, su adopción dentro del ecosistema es evidente. Herramientas como Microsoft Presidio ya han incorporado su soporte para la detección de datos sensibles, lo cual sugiere su utilidad en flujos de privacidad y análisis documental.
En definitiva, el verdadero aporte de LangExtract no radica en desbancar las soluciones existentes, sino en replantear las expectativas sobre lo que debería ofrecer una herramienta de extracción documental basada en inteligencia artificial. Su capacidad de combinar extracción estructurada, trazabilidad, visualización interactiva y compatibilidad multiplataforma desafía a las herramientas tradicionales a justificar su costo, rigidez y falta de auditabilidad. LangExtract plantea una pregunta crucial en el campo de la IA aplicada a documentos: ¿podemos confiar en los datos extraídos?
Más información y referencias en Noticias Cloud.