
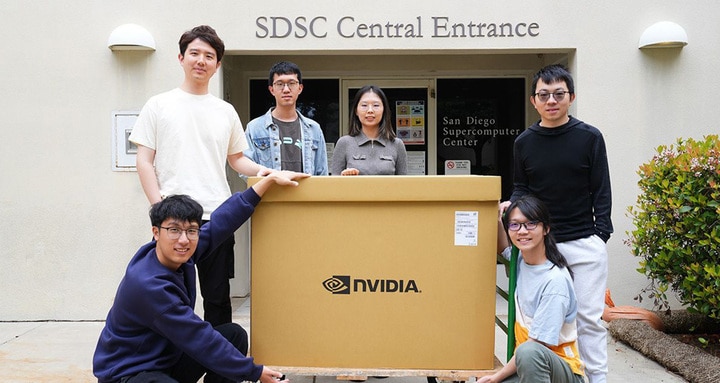
La carrera por ofrecer modelos de lenguaje con baja latencia ha dejado de ser un mero desafío en artículos académicos y pruebas de referencia, avanzando hacia un terreno donde el verdadero reto es cómo estas soluciones se implementan en producción. En este contexto, el Hao AI Lab de la University of California San Diego (UC San Diego) ha dado un paso significativo al incorporar un sistema NVIDIA DGX B200, con el propósito de acelerar la inferencia de grandes modelos. Esta innovadora infraestructura no solo beneficiará al laboratorio, sino que estará disponible para toda la comunidad universitaria a través del San Diego Supercomputer Center.
El interés de esta actualización técnica va más allá del simple titular «nuevo hardware». Las innovaciones del Hao AI Lab han influido profundamente en las actuales soluciones de inferencia. NVIDIA resalta que los conceptos desarrollados en este laboratorio han sido fundamentales en enfoques contemporáneos de inferencia, como DistServe, que se centra en mejorar la eficiencia sin comprometer la experiencia del usuario.
Históricamente, la métrica dominante para los motores de inferencia era el throughput, es decir, cuántos tokens por segundo genera el sistema. Sin embargo, esta métrica por sí sola no refleja la experiencia del usuario. La reducción de la latencia, aunque afecta al throughput, es crucial para mejorar la percepción y la interacción humana con el sistema. Aquí es donde entra en juego el concepto de «goodput», una métrica que intenta capturar el rendimiento útil al cumplir con objetivos de latencia establecidos. Esta noción es particularmente relevante ahora que los modelos de lenguaje grande (LLM) buscan ser más que demos y convertirse en productos con exigencias de servicio reales.
La arquitectura tradicional de los sistemas de inferencia ha dividido el flujo de trabajo en dos etapas: prefill y decode. Tradicionalmente, ambos procesos se ejecutaban en la misma GPU, compitiendo por recursos limitados. La nueva estrategia de «disagregación» permite separar estas etapas en diferentes grupos de GPU, reduciendo la interferencia y mejorando el goodput. NVIDIA ha promovido este enfoque como una vía para escalar operaciones sin renunciar a la baja latencia necesaria para aplicaciones de alto rendimiento.
La elección de un sistema DGX B200 en el laboratorio de UC San Diego no es casualidad. Este sistema, equipado con ocho GPUs NVIDIA B200 y concebido para altas demandas de memoria y comunicación interna, representa un acceso a capacidades de prototipado y experimentación rápidas. La infraestructura avanzada de NVIDIA, con su interconexión de alta velocidad, facilita la búsqueda de latencias consistentes y un rendimiento sostenido bajo carga intensiva, permitiendo al equipo de UC San Diego iterar rápidamente en la investigación de soluciones innovadoras.
Este avance tecnológico en el Hao AI Lab está estrechamente ligado a proyectos de vanguardia como FastVideo y Lmgame-bench. FastVideo tiene como objetivo entrenar modelos para generación de video que puedan producir clips en sólo cinco segundos a partir de un prompt, alcanzando así un umbral crítico que transforma la experiencia de usuario de «esperar» a «interactuar». Por otro lado, Lmgame-bench utiliza videojuegos populares para evaluar modelos, replicando condiciones similares a las exigencias de sistemas en producción.
En conclusión, lo que puede parecer una mejora de infraestructura en el ámbito académico es en realidad un indicador de cómo la inferencia está evolucionando hacia una disciplina propia. Las innovaciones como el goodput, las nuevas arquitecturas de disagregación y las herramientas avanzadas para la industrialización de la inferencia con baja latencia están configurando el futuro del sector. La próxima ventaja competitiva no consistirá solo en entrenar modelos más grandes, sino en la capacidad de servirlos eficientemente, optimizando la experiencia, la eficiencia y el escalado.
Más información y referencias en Noticias Cloud.