
La optimización de las aplicaciones de inteligencia artificial generativa ha dado un paso hacia adelante con la introducción de técnicas avanzadas que permiten la personalización y eficiencia en el ajuste de modelos base. En este contexto, la ingeniería de prompts, la recuperación de documentos (RAG), el preentrenamiento continuo y el ajuste fino se han convertido en herramientas esenciales para maximizar el rendimiento y minimizar el consumo de recursos.
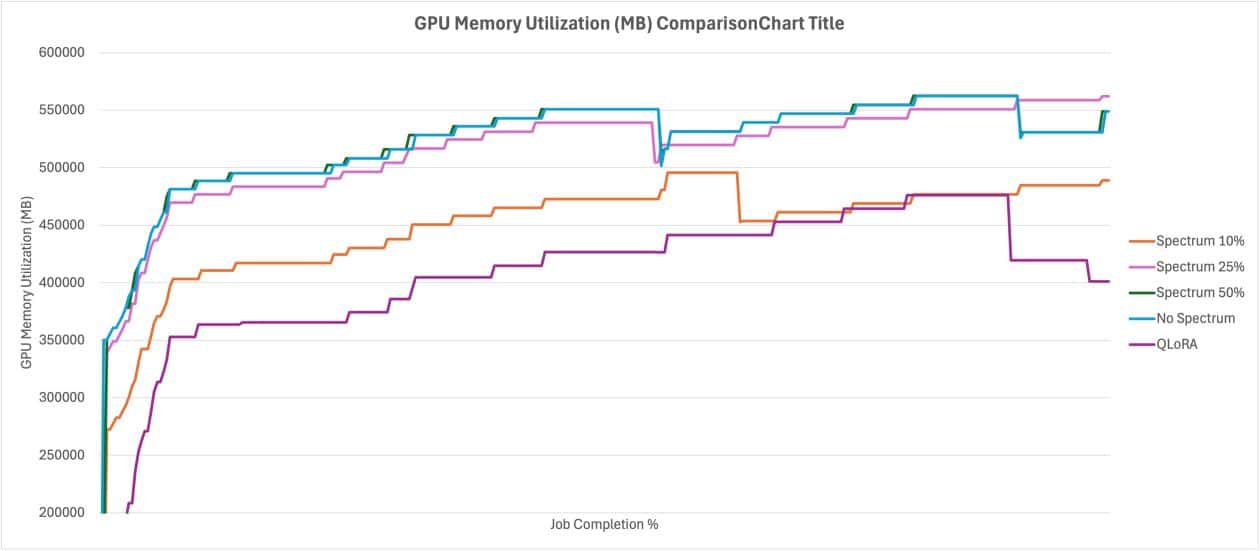
Un avance significativo en este ámbito es el novedoso enfoque denominado Spectrum. Este método innovador se centra en identificar las capas más informativas dentro de un modelo base, permitiendo un ajuste fino más focalizado y eficiente. Al ajustar solamente una parte del modelo, Spectrum no solo optimiza el uso de recursos, sino que también reduce los tiempos de entrenamiento sin comprometer la calidad del resultado final.
Entre las técnicas destacadas para afinar modelos de lenguaje, Quantized LoRA (QLoRA) ha ganado popularidad por su capacidad para combinar la adaptación de rango bajo con la cuantización del modelo original durante el entrenamiento. Sin embargo, QLoRA aplica este enfoque de manera uniforme a lo largo de todo el modelo, mientras que Spectrum ofrece una alternativa que promete un rendimiento aún superior al enfocarse de manera selectiva en las capas más críticas.
La implementación de Spectrum permite analizar las matrices de peso en cada capa de un modelo base para calcular la Relación Señal/Ruido (SNR), lo que permite determinar qué capas deben ser entrenadas en alta resolución. Este análisis se lleva a cabo mediante la Teoría de Matrices Aleatorias y la distribución de Marchenko-Pastur, que distinguen entre señal y ruido con eficacia.
Un ejemplo práctico de la implementación de Spectrum se encuentra en los trabajos gestionados en Amazon SageMaker AI, donde se lleva a cabo el ajuste fino del modelo Qwen3-8B. Este proceso comienza con la descarga y análisis del modelo para determinar el SNR de sus capas, permitiendo así la identificación de aquellas que se beneficiarán del ajuste fino, mientras el resto permanece congelado.
Para llevar a cabo este proceso es necesario contar con una cuenta de AWS con permisos adecuados y configurar Amazon SageMaker Studio para ejecutar el código en un notebook Jupyter. La clonación del repositorio Spectrum y la ejecución de los scripts de análisis proporcionan una guía detallada sobre las capas más influyentes en el entrenamiento.
Finalmente, los resultados de los análisis generan un archivo que especifica las capas clave para el ajuste fino, optimizando de este modo el uso de recursos y asegurando un proceso más eficiente y preciso. Esta innovación plantea nuevas posibilidades en el campo de la inteligencia artificial, promoviendo un enfoque más efectivo en el desarrollo de modelos adaptativos y personalizados.