
En un entorno donde las aplicaciones de inteligencia artificial exigen eficiencia y velocidad, Amazon SageMaker HyperPod ha dado un paso significativo al incorporar capacidades avanzadas de gestión de cacheo y enrutamiento inteligente para mejorar el rendimiento de los modelos de lenguaje grande (LLM). Este avance se presenta como una solución crucial a los retos que enfrentan las empresas al manejar documentos extensos y conversaciones complejas.
El desafío de la latencia en los procesos de inferencia de LLM, agravado por la necesidad de recalcular los mecanismos de atención para cada nuevo token, ha sido histórico en el campo de la inteligencia artificial. Esta recalibración continuada no solo incrementa la carga computacional, sino que también eleva los costos operativos. Sin embargo, con la introducción del almacenamiento en caché de clave-valor (KV), se ha dado un paso hacia la optimización. Este método permite guardar y reutilizar vectores de atención de cálculos anteriores, disminuyendo así significativamente el tiempo y costo de inferencia.
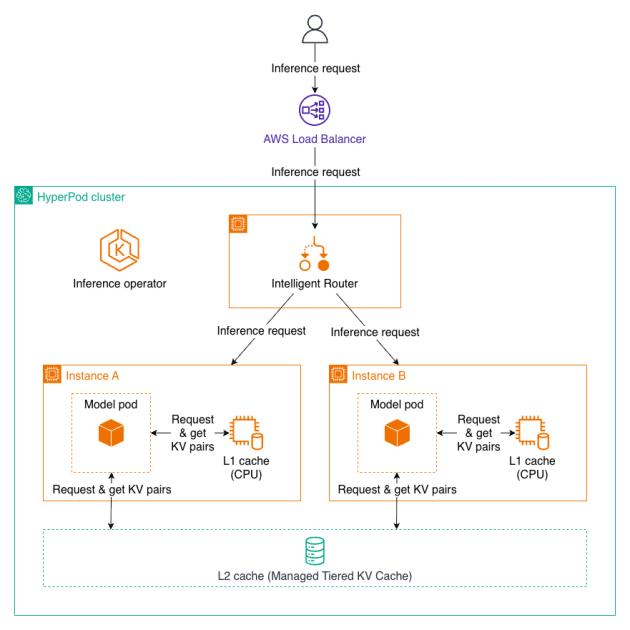
El reciente anuncio de Amazon destaca que SageMaker HyperPod ahora es compatible con la Gestión de Caché de KV en Niveles y el Enrutamiento Inteligente mediante el Operador de Inferencia de HyperPod. Estas características prometen una reducción del 40% en el tiempo hasta el primer token, lo que se traduce en un incremento en el rendimiento y una disminución de los costos computacionales de hasta un 25% para interacciones extensas.
Este sistema eficiente maximiza los aciertos del caché, mejorando tanto el rendimiento como la economía en la implementación de modelos de lenguaje. Su aplicación abarca desde el análisis instantáneo de documentos legales extensos hasta la mejora de las conversaciones en servicios de atención al cliente, haciendo estas operaciones más rentables a gran escala.
La implementación de estas capacidades innovadoras no solo promete mejoras en los costos y el rendimiento, sino que también introduce nuevas estrategias de enrutamiento, integrando observabilidad y rastreo de métricas mediante Amazon Managed Grafana. Este enfoque integral asegura que las empresas sean capaces de escalar sus operaciones de inteligencia artificial sin el lastre de los altos costos y los tiempos de espera prolongados.
En conjunto, estos avances posicionan a Amazon como un referente en soluciones de inteligencia artificial escalables, brindando a las empresas herramientas efectivas y rentables para manejar las crecientes demandas del mercado moderno.