
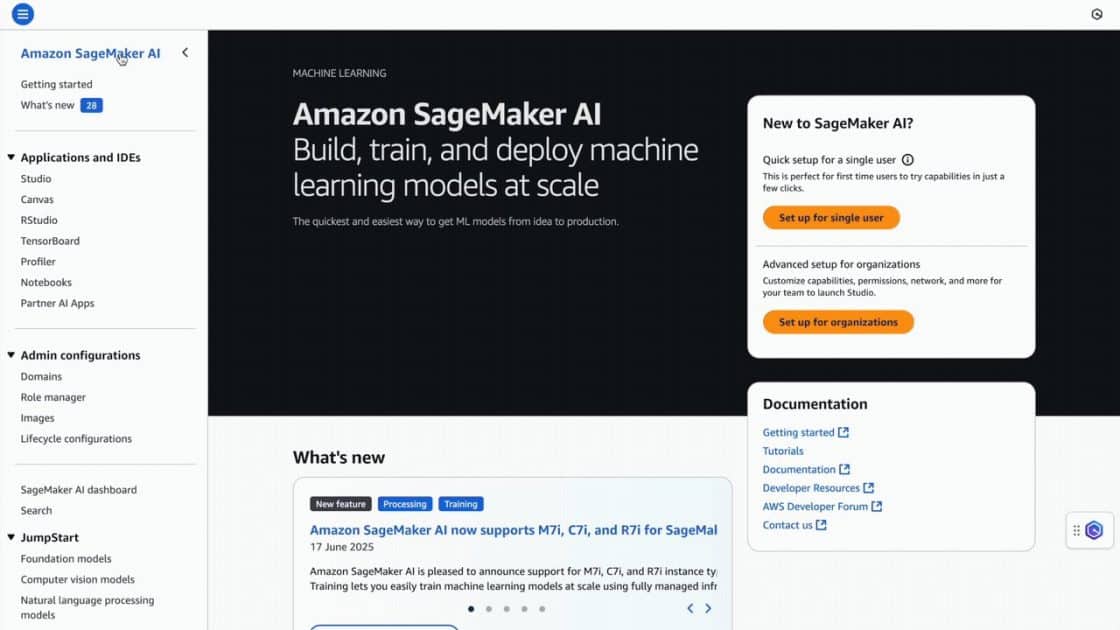
Desplegar modelos de aprendizaje automático (ML) en producción puede ser una tarea compleja, especialmente para aquellos sin experiencia en ML y DevOps. Ahora, Amazon SageMaker Canvas simplifica el proceso, ofreciendo una interfaz sin código que permite a los usuarios crear modelos de ML precisos sin necesidad de programar.
Amazon SageMaker Serverless Inference es clave en este avance. Diseñado para manejar cargas de trabajo con tráfico variable y períodos de inactividad, el servicio gestiona automáticamente la infraestructura necesaria, eliminando la complicación de manejar servidores o configurar capacidades.
El flujo de trabajo para pasar de un modelo creado en SageMaker Canvas a un entorno de producción con SageMaker Serverless Inference es sencillo. Comprende etapas como añadir el modelo al registro de SageMaker y crear un endpoint sin servidor, todo sin gestionar infraestructura.
Los requerimientos incluyen acceso a Amazon S3 y Amazon SageMaker AI, además de tener un modelo de regresión o clasificación previamente entrenado y listo para registrarse y aprobarse para su despliegue.
El proceso contempla dar un nombre al modelo, seleccionar el contenedor adecuado y configurar las variables de entorno necesarias. Finalmente, se establece la configuración del endpoint y se lanza.
Esta arquitectura eficiente permite a empresas de todos los tamaños implementar modelos de ML de manera simplificada. Al aprovechar estas herramientas, se reduce la complejidad de gestión de infraestructura, permitiendo a las organizaciones recibir predicciones efectivas y rápidamente.