
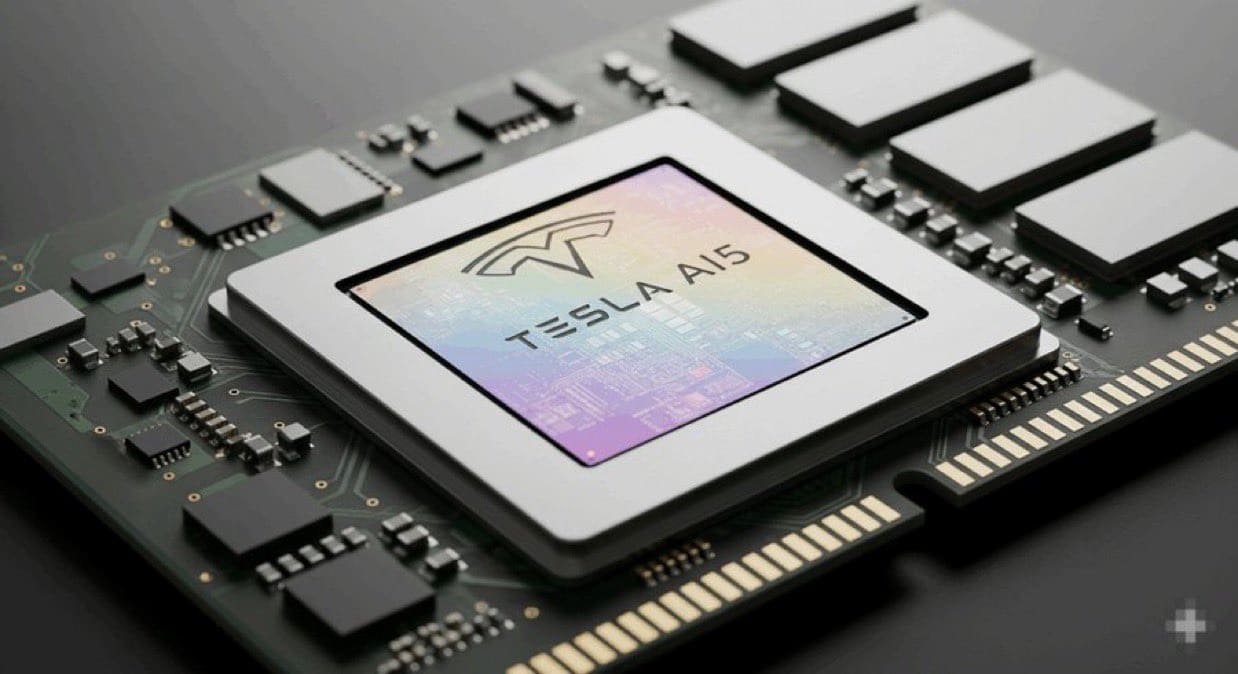
Recientemente, un mensaje viral ha capturado la atención de las redes, sugiriendo que Tesla ha desarrollado una innovadora técnica que permite que hardware de 8 bits (INT8) ejecute operaciones de 32 bits (FP32) utilizadas por modelos tipo Transformer, sin perder precisión. Esta información, presentada con un tono épico, vincula la supuesta tecnología con capacidades de conducción autónoma y robótica avanzada, incluyendo humanoides como el proyecto Optimus.
Sin embargo, este mensaje no solo está cargado de sensacionalismo, sino que combina conceptos legítimos con afirmaciones potencialmente engañosas. Para el consumidor técnicamente informado, el enfoque debería centrarse en discernir qué parte de estas afirmaciones corresponde al estado actual de la tecnología y cuál requiere evidencia concreta.
En el núcleo de la discusión se encuentra el método conocido como Rotary Positional Embedding (RoPE), una técnica que ayuda a los modelos Transformer a codificar la posición de forma más eficaz a través de rotaciones en el espacio de embeddings. RoPE, popularizado por el modelo RoFormer, es ampliamente adoptado por mejorar la generalización en contextos más largos y simplificar detalles frente a métodos tradicionales. Esta técnica, que se apoya en funciones trigonométricas como senos y cosenos, es susceptible a errores numéricos si no se implementa con cuidado, pero también permite aproximaciones ingeniosas para acotar el error con el mínimo costo computacional.
La industria ya aplica técnicas de precisión mixta y cuantización para mejorar la eficiencia. Tesla, al igual que otros líderes en inteligencia artificial embebida, puede emplear precisión mixta usando INT8 o INT4 donde es viable y reservando FP16 o FP32 para secciones críticas, algo común y necesario para despliegues eficientes.
La parte más dudosa del mensaje viral es la que sugiere que chips de 8 bits pueden llevar a cabo tareas de 32 bits sin pérdida de precisión. En realidad, los sistemas eficaces consiguen esto manteniendo la información crítica en un formato que minimiza el error, utilizando componentes de mayor precisión para la corrección final cuando es necesario, y tolerando errores controlados que no afectan significativamente el resultado final.
Además, las técnicas de almacenamiento en caché de claves y valores (KV-cache) y la atención paginada se mencionan en el mensaje viral como fundamentales para manejar contextos largos. El verdadero cuello de botella durante la inferencia a menudo no es la unidad aritmético-lógica (ALU), sino el uso de memoria y el ancho de banda, particularmente porque el tamaño de la KV-cache aumenta con el número de tokens y capas. Avances como vLLM y su enfoque de PagedAttention demuestran cómo la administración eficiente de estas caches puede mejorar significativamente el desempeño.
Conclusión: el mensaje viral, aunque intrigante, exagera las posibilidades del hardware actual al sugerir una capacidad de cálculo imposible sin una pérdida tangible de precisión. Para que estas afirmaciones sean validadas de manera técnica, se necesitaría una arquitectura detallada, límites de error claros y benchmarks reproducibles que muestren el supuesto ahorro. Los actores técnicos deben evaluar cualquier afirmación viral con una mirada crítica, especialmente considerando factores de seguridad y robustez que son cruciales en aplicaciones como la conducción autónoma o la robótica avanzada. La verdadera innovación radicaría no solo en cómo Tesla adopta estas tecnologías, sino también en su capacidad para integrarse de manera segura y eficaz en sus ofertas de productos.
Más información y referencias en Noticias Cloud.