
En un esfuerzo por satisfacer la creciente necesidad de inferencias más rápidas y eficientes en los modelos de inteligencia artificial generativa (IAG), Amazon SageMaker AI ha lanzado una innovación significativa. A través de la introducción de la decodificación especulativa adaptativa basada en EAGLE (Extrapolation Algorithm for Greater Language-model Efficiency), se ha mejorado el conjunto de herramientas de optimización de inferencias, acelerando el procesamiento de datos en una amplia gama de arquitecturas de modelos.
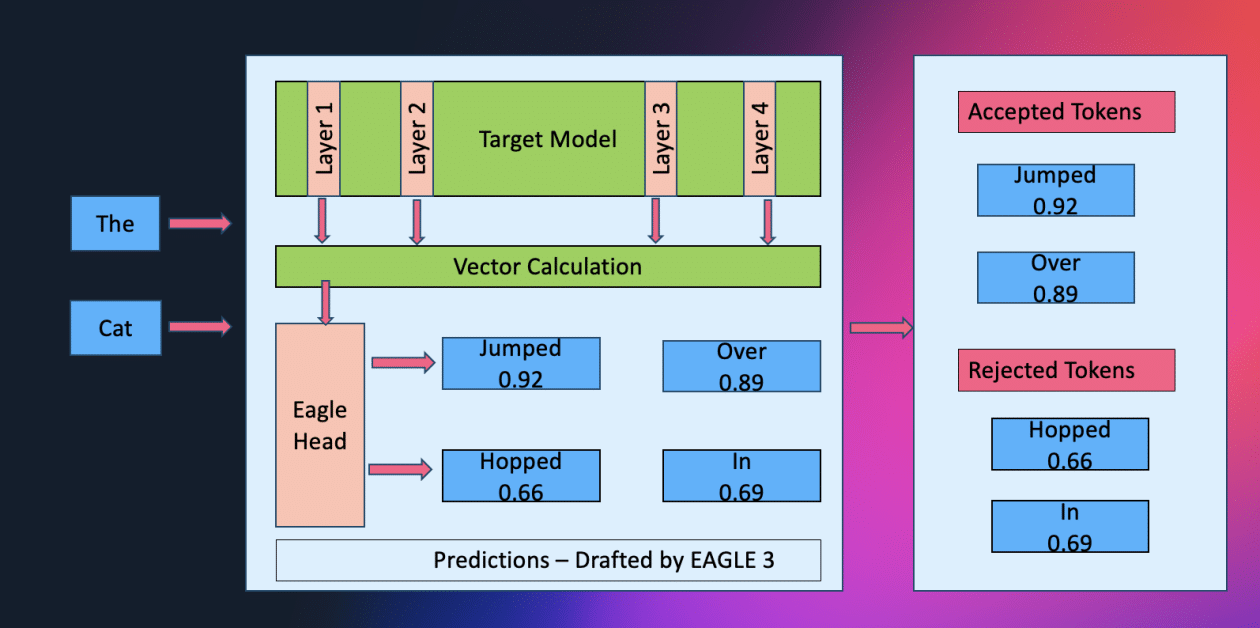
EAGLE es una técnica innovadora que facilita la decodificación de grandes modelos lingüísticos al predecir tokens futuros directamente desde las capas internas del modelo. Al sincronizar la optimización con datos específicos de aplicaciones, las mejoras ofrecen inferencias más veloces que están alineadas con las cargas de trabajo reales del usuario, dejando atrás los enfoques basados en puntos de referencia genéricos. Esto se logra mediante la capacitación de módulos adicionales, conocidos como cabezales EAGLE 2 o EAGLE 3, que dependen de la estructura del modelo.
Estas mejoras no se limitan a una aplicación única. Los usuarios pueden comenzar con conjuntos de datos proporcionados por SageMaker para el entrenamiento inicial y luego afinar el modelo con sus propios datos, permitiendo así un rendimiento altamente personalizado. Herramientas como Data Capture permiten la recopilación de datos en tiempo real para ajustar el modelo a través de experiencias de usuario concretas.
Con soporte nativo para EAGLE 2 y EAGLE 3, SageMaker AI ofrece una flexibilidad sin precedentes. Los usuarios tienen la opción de emplear modelos JumpStart de SageMaker o importar modelos de repositorios externos, como HuggingFace. Esto permite que cada arquitectura aplique la técnica más adecuada a su diseño intrínseco.
La técnica de decodificación especulativa optimiza el tiempo de inferencia al utilizar un modelo más pequeño para la generación preliminar de tokens, los cuales son luego validados por el modelo principal de destino. Mediante la implementación de EAGLE, se incrementa la eficiencia al reutilizar características del modelo objetivo, siempre que el modelo base sea seleccionado adecuadamente.
El enfoque EAGLE brinda al modelo la capacidad de actuar como su propio aliado experimental, permitiendo que examine sus representaciones internas y anticipe múltiples tokens futuros de manera paralela. Esto no solo reduce el tiempo de inferencia, sino que también mejora la precisión y alivia los cuellos de botella en la memoria, marcando una mejora considerable en el rendimiento general.
SageMaker ofrece a los usuarios la oportunidad de construir o mejorar modelos EAGLE de diversas maneras, incluyendo el entrenamiento desde cero con datos curados por SageMaker, la utilización de datos propios o el inicio desde un modelo base preexistente. Adicionalmente, SageMaker JumpStart proporciona modelos EAGLE preentrenados, facilitando que los usuarios optimicen sus modelos desde el principio.
La posibilidad de ajustar los modelos con conjuntos de datos propios permite que las aplicaciones reflejen las características específicas de su comportamiento, logrando un rendimiento optimizado. Esta herramienta de optimización de inferencias está diseñada para que los desarrolladores ofrezcan aplicaciones generativas con menor latencia y mayor escalabilidad, repercutiendo en un ahorro significativo de tiempo en el procesamiento y manejo de datos. En resumen, las mejoras introducidas por SageMaker AI con EAGLE representan un avance hacia una inteligencia artificial más rápida y eficiente en el manejo de grandes cantidades de información.