
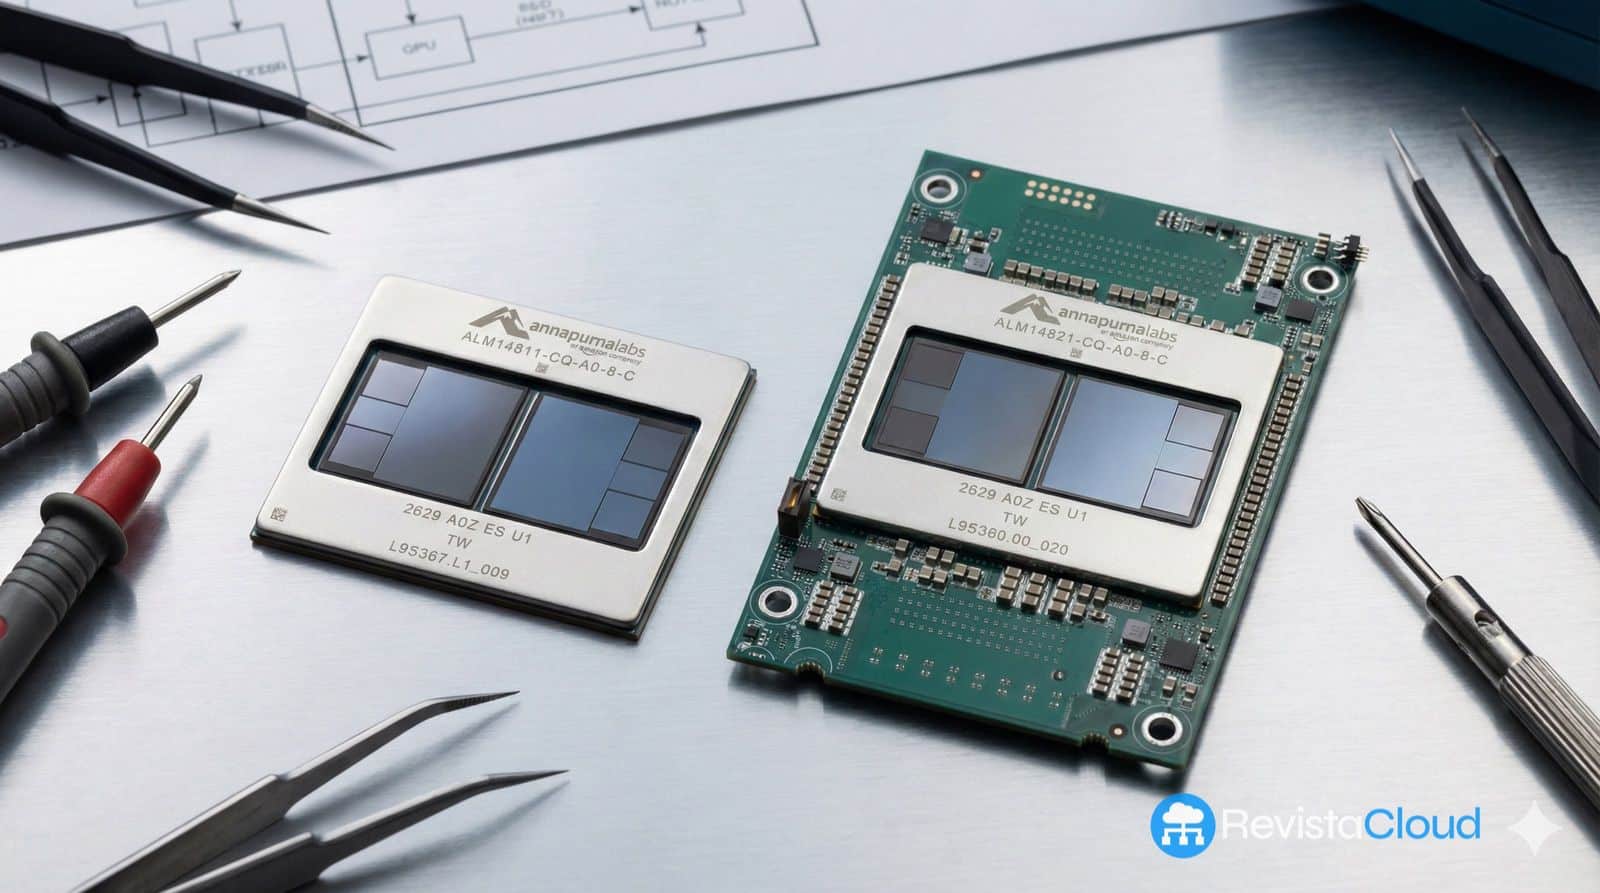
Amazon ha dado un paso decisivo en el AWS re:Invent 2025, posicionándose con firmeza en la contienda del hardware para inteligencia artificial al presentar sus innovadores servidores Trainium3 UltraServers y anticipar detalles del próximo Trainium4. Con esta jugada, la compañía deja clara su intención de reducir la dependencia de GPUs de terceros, proponiendo una solución propia y robusta para el cómputo masivo de modelos de IA.
Los Amazon EC2 Trn3 UltraServers son la joya de la corona del evento. Estos sistemas concentran hasta 144 chips Trainium3 en un «super-servidor» cuyo objetivo es optimizar el entrenamiento y la ejecución de modelos de IA de gran escala. AWS comenta que los UltraServers ofrecen un desempeño que es 4,4 veces superior al de la generación anterior, Trainium2 UltraServers, y logran ser aproximadamente cuatro veces más eficientes en términos energéticos. Además, con casi cuatro veces más ancho de banda de memoria, estas mejoras son cruciales para gestionar grandes cantidades de datos sin crear cuellos de botella, consiguiendo reducir entrenamientos prolongados de meses a semanas y optimizando el coste por consulta para aplicaciones de gran demanda como chatbots y agentes de IA.
La aportación técnica de Trainium3 no se limita a los chips, sino que integra soluciones de red como el NeuronSwitch-v1, un conmutador que duplica el ancho de banda interno, y un tejido de red Neuron Fabric que minimiza la latencia de comunicación a menos de 10 microsegundos, aspecto crítico en los entrenamientos distribuidos. Adicionalmente, los EC2 UltraClusters 3.0 permiten agrupar estos UltraServers para formar clusters con hasta un millón de chips Trainium, abriendo la puerta a entrenar modelos multimodales de proporciones colosales.
Empresas como Anthropic y Metagenomi comienzan a beneficiarse de los ahorros del 50% en costes que ofrece Trainium frente a soluciones GPU tradicionales. Un ejemplo notable es Decart, que logra incrementar la velocidad de inferencia por un factor de cuatro, al tiempo que reduce sus costes a la mitad en la generación de vídeo, facilitando el desarrollo de experiencias interactivas en vivo y asistencias gráficas en tiempo real. Amazon Bedrock ya ha integrado Trainium3 en sus cargas de producción, reforzando su papel como componente esencial de su propuesta de valor.
Mirando al futuro, Trainium4 promete al menos 6 veces más rendimiento en FP4 y 3 veces más en FP8, junto con un aumento de cuatro veces en ancho de banda de memoria. Esta nueva generación se integrará con la tecnología NVIDIA NVLink Fusion, permitiendo una integración eficiente entre servidores Trainium y las soluciones GPU de NVIDIA, lo que otorga una versatilidad sin precedentes en infraestructuras de alto rendimiento.
El paso dado por Amazon ilustra su estrategia de control sobre el hardware de IA, en un contexto de competencia feroz donde gigantes como Google y Microsoft buscan también minimizar dependencias externas. Al ofrecer estas capacidades avanzadas como servicio EC2, AWS democratiza parcialmente el acceso a tecnologías que anteriormente estaban reservadas a players con la capacidad de desarrollar infraestructuras propias extremas.
Para las empresas, esto implica entrenamientos más rápidos, inferencia más barata y nuevas posibilidades de arquitectura híbrida, permitiendo una mayor flexibilidad en el diseño de soluciones. El movimiento refuerza la idea de una infraestructura de IA que no solo es definida por el software, sino también por el silicio, evidenciando que la carrera actual no se limita al desarrollo de modelos, sino a la creación de una infraestructura dinámica, eficiente y escalable. Con Trainium3 y el prometedor Trainium4, Amazon no solo participa en la carrera, sino que pretende ser un líder en el futuro del cómputo para inteligencia artificial a escala global.
Más información y referencias en Noticias Cloud.